तुम्ही कधी ChatGPT किंवा Google Assistant ला शुद्ध मराठीत, तुमच्या नेहमीच्या बोलीत काही विचारून बघितलंय का? बरेचदा ते नीट समजतच नाही, किंवा उत्तर विचित्र, तुटक इंग्रजी-मराठी मिश्रित येतं. याचं मुख्य कारण म्हणजे आतापर्यंतचे बहुतेक मोठे AI मॉडेल्स हे इंग्रजी Data वर तयार झालेले आहेत, आणि मराठी, हिंदी, तमिळ यांसारख्या भारतीय भाषा त्यांच्यासाठी नेहमीच “afterthought” राहिल्या आहेत.
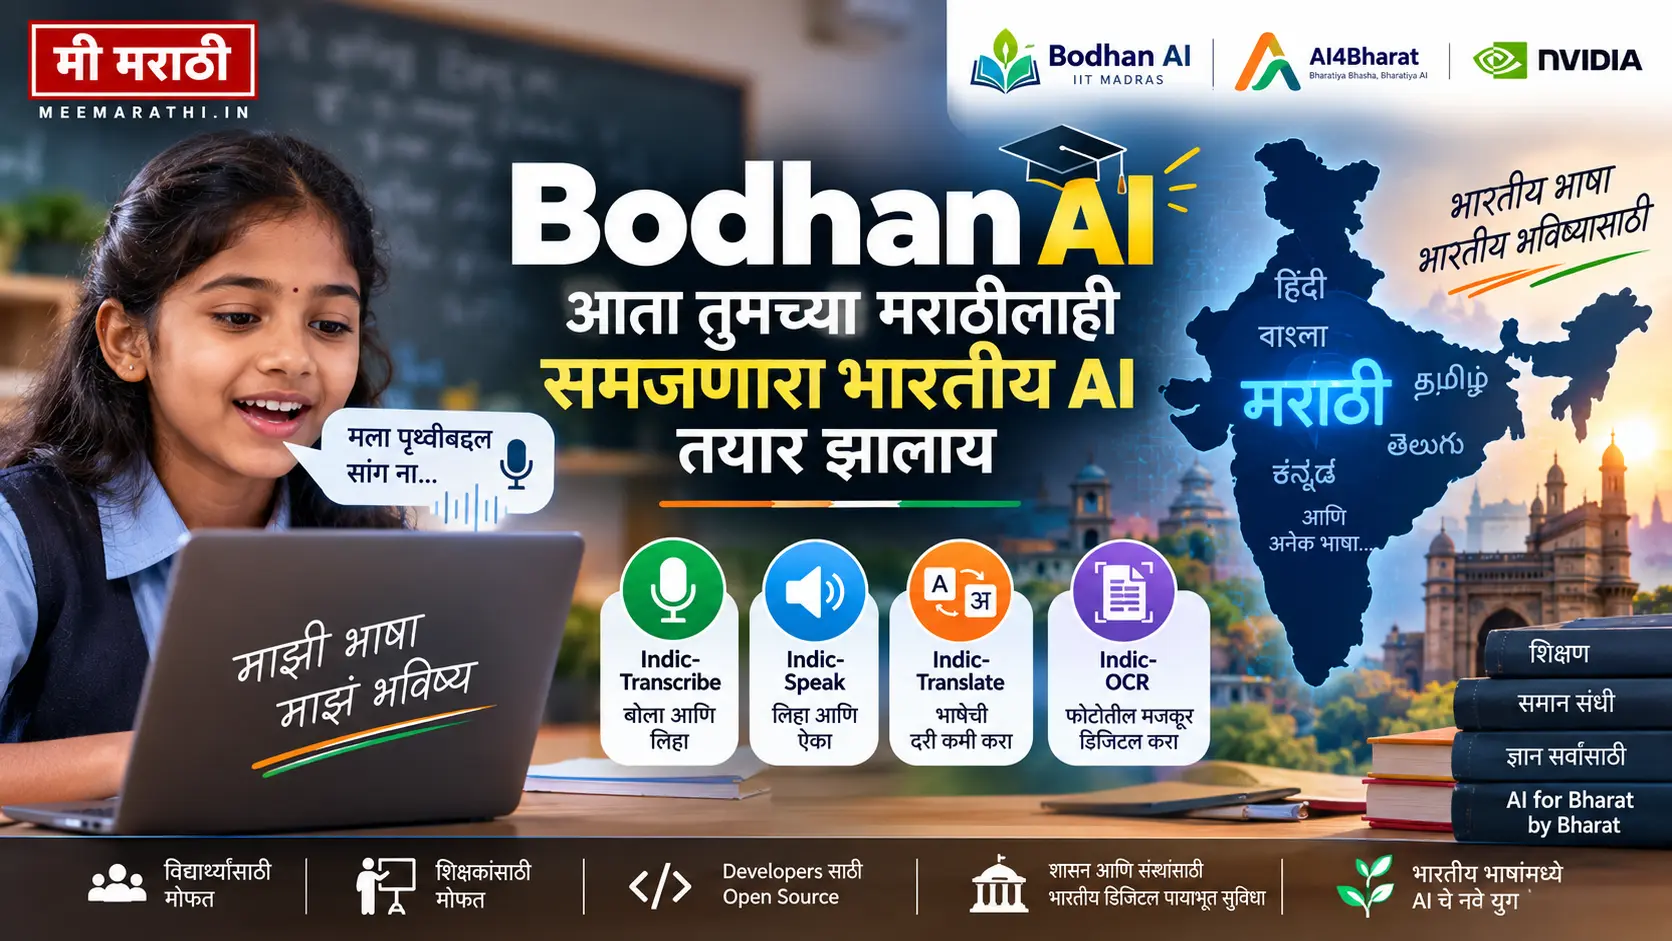
आता ही परिस्थिती बदलायला सुरुवात झाली आहे. सप्टेंबर 2026 मध्ये IIT Madras मधल्या Bodhan AI या संस्थेने, AI4Bharat आणि NVIDIA यांच्या सहकार्याने, खास भारतीय भाषांसाठी बनवलेले चार नवीन AI मॉडेल्स खुले (open-source) केले आहेत. आणि सर्वात आनंदाची गोष्ट म्हणजे यात मराठीचाही समावेश आहे.
Bodhan AI म्हणजे नेमकं काय
Bodhan AI ही IIT Madras मधून उभी राहिलेली एक संस्था आहे, जी खास शिक्षण क्षेत्रातल्या AI साठी काम करते. फेब्रुवारी 2026 मध्ये या संस्थेचं उद्घाटन झालं होतं. या संस्थेचा उद्देश स्पष्ट आहे, भारतातल्या शाळा आणि महाविद्यालयांमध्ये शिकणाऱ्या विद्यार्थ्यांना त्यांच्याच भाषेत, त्यांच्याच पद्धतीने शिकवणारं तंत्रज्ञान तयार करणं.
यासाठी Bodhan AI ने AI4Bharat या संस्थेशी हातमिळवणी केली आहे. AI4Bharat हे आधीपासूनच भारतीय भाषांवर काम करणारं एक अग्रगण्य संशोधन केंद्र आहे, ज्यांच्याकडे मराठीसह अनेक भारतीय भाषांचे मोठे डेटासेट आणि वर्षानुवर्षांचा अनुभव आहे. या दोघांनी मिळून, आणि NVIDIA च्या तांत्रिक सहकार्याने, चार पायाभूत (foundational) AI मॉडेल्स तयार केले आहेत.
हे चार मॉडेल्स नेमकं काय करतात
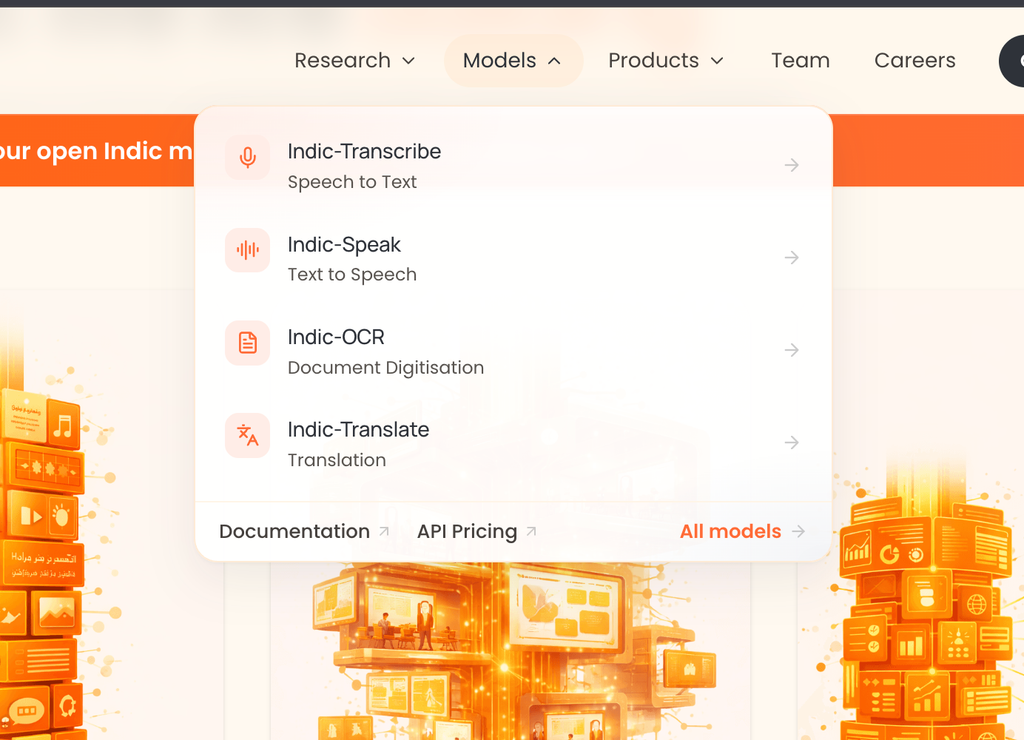
हे समजून घेण्यासाठी आधी एक गोष्ट लक्षात घेऊ. आपण जेव्हा मोबाईलवर बोलतो, टाइप करतो, किंवा एखादा फोटो काढून त्यातला मजकूर वाचायला सांगतो, तेव्हा त्यामागे वेगवेगळ्या प्रकारचं AI काम करत असतं. Bodhan AI ने नेमकी हीच चार कामं भारतीय भाषांसाठी सक्षम बनवली आहेत.
पहिलं मॉडेल आहे Indic-Transcribe, जे आवाज ऐकून त्याचं अचूक लिखित रूपांतर करतं. म्हणजे तुम्ही मराठीत बोलाल, तर ते बरोबर मराठीत टाइप होईल, अगदी तुम्ही मध्येच इंग्रजी शब्द वापरले (जसं “मला उद्या meeting आहे”) तरीही ते व्यवस्थित समजतं.
दुसरं मॉडेल आहे Indic-Speak, जे उलट काम करतं, म्हणजे लिखित मजकूर वाचून तो नैसर्गिक आवाजात बोलून दाखवतं. हे विशेषतः त्या विद्यार्थ्यांसाठी उपयुक्त आहे ज्यांना वाचायला अडचण येते, किंवा ज्यांना ऐकून शिकणं जास्त सोपं वाटतं.
तिसरं मॉडेल आहे Indic-Translate, जे एका भारतीय भाषेतून दुसऱ्या भाषेत, किंवा इंग्रजीतून भारतीय भाषेत अचूक भाषांतर करतं. हे मराठी शिक्षक आणि विद्यार्थ्यांसाठी खूप मोठी मदत ठरू शकतं, कारण इंग्रजीत उपलब्ध असलेला भरपूर शैक्षणिक मजकूर आता सहज मराठीत आणता येईल.
चौथं आणि शेवटचं मॉडेल आहे Indic-OCR, जे स्कॅन केलेल्या किंवा फोटो काढलेल्या पानांमधला मजकूर वाचून तो डिजिटल, शोधण्यायोग्य स्वरूपात रूपांतरित करतं. जुन्या मराठी पुस्तकांचे फोटो, हाताने लिहिलेल्या नोट्स, किंवा टेबल्स यांनाही हे मॉडेल हाताळू शकतं.
मराठी बोलणाऱ्यांसाठी सर्वात खास काय आहे
या प्रकल्पातली सर्वात कौतुकास्पद गोष्ट म्हणजे यातलं आवाज ओळखणारं मॉडेल तब्बल 27 भारतीय भाषा आणि बोलींना सामावून घेतं. यात प्रादेशिक बदल, उच्चारांतले फरक, आणि आपण रोज जसं बोलतो तसं इंग्रजी-मराठी मिश्रित बोलणंही (ज्याला “Minglish” म्हणता येईल, जसं “Tanglish” किंवा “Hinglish” म्हणतात तसं) समजण्याची क्षमता या मॉडेलमध्ये आहे.
हे मॉडेल तयार करताना NVIDIA च्या Nemotron 3.5 ASR या तंत्रज्ञानाचा वापर करून, त्याला खास भारतीय शाळांमधल्या प्रत्यक्ष वर्गातल्या आवाजाच्या डेटावर आणखी प्रशिक्षित (post-trained) करण्यात आलं आहे. म्हणजे हे मॉडेल फक्त प्रयोगशाळेत तयार झालेलं नाही, तर खऱ्याखुऱ्या भारतीय वर्गातल्या गोंगाटातही, मुलांच्या नैसर्गिक बोलण्याच्या पद्धतीतही ते नीट काम करेल अशा उद्देशाने बनवलं गेलं आहे.
हे मोफत आहे का, आणि ते वापरून कोण काय करू शकतं
हा प्रश्न सगळ्यात आधी मनात येतो, आणि इथे उत्तर खरोखर आनंददायी आहे. हे चारही मॉडेल्स open-weight स्वरूपात प्रकाशित केले गेले आहेत, म्हणजे कुणीही, कुठलाही डेव्हलपर, स्टार्टअप, संशोधक, विद्यापीठ किंवा सरकारी संस्था हे मॉडेल्स मोफत डाउनलोड करून त्यांच्यावर स्वतःची अॅप्लिकेशन्स बनवू शकते.
याशिवाय, ही मॉडेल्स hosted API स्वरूपातही उपलब्ध आहेत, जे भारताच्याच सार्वभौम (sovereign) डिजिटल पायाभूत सुविधेवर चालवली जातात. सर्वात महत्त्वाची गोष्ट म्हणजे Bodhan AI ने स्पष्टपणे सांगितलं आहे की या मॉडेल्सवर आधारित शैक्षणिक अॅप्लिकेशन्स विद्यार्थी, शिक्षक आणि सहभागी राज्य सरकारांसाठी कायमच मोफत राहतील.
Bodhan AI चे प्रमुख संशोधक प्रा. मितेश खापरा यांनी एका वक्तव्यात स्पष्टपणे म्हटलं आहे की, “Bodhan AI ला ecosystem सोबत स्पर्धा करायची नाही, तर त्या ecosystem सोबत मिळून काम करायचं आहे.” हीच भूमिका या प्रकल्पाला इतर बंद (closed-source), मोठ्या टेक कंपन्यांच्या मॉडेल्सपेक्षा वेगळी बनवते.
हा प्रकल्प Bharat EduAI Stack नावाच्या मोठ्या योजनेचा एक भाग आहे. ही संकल्पना समजण्यासाठी एक सोपी तुलना करता येईल. ज्याप्रमाणे UPI ने भारतात डिजिटल पैशांची देवाणघेवाण सोपी आणि सर्वांसाठी उपलब्ध करून दिली, आणि आधारने ओळख पडताळणी सुलभ केली, त्याचप्रमाणे Bharat EduAI Stack शिक्षण क्षेत्रासाठी एक समान, सार्वजनिक डिजिटल पायाभूत सुविधा उभी करू इच्छिते.
याचा अर्थ असा की भविष्यात कुठलाही स्टार्टअप, कुठलीही एडटेक कंपनी, किंवा अगदी एखादी शाळाही या पायावर स्वतःचं मराठी शिक्षण अॅप उभं करू शकेल, आणि त्यासाठी त्यांना पुन्हा एकदा भाषेचं मॉडेल शून्यापासून तयार करण्याची गरज भासणार नाही. यामुळे संपूर्ण भारतीय भाषा AI परिसंस्था झपाट्याने वाढू शकते.
याचा फायदा कुणाला आणि कसा होईल
एका ग्रामीण भागातल्या शाळेतल्या शिक्षकाचं उदाहरण घेऊ. समजा त्यांच्याकडे इंग्रजीत उत्तम शैक्षणिक साहित्य उपलब्ध आहे, पण विद्यार्थ्यांना ते मराठीत हवं आहे. Indic-Translate मॉडेलच्या मदतीने असं साहित्य वेगाने आणि अचूकपणे मराठीत आणता येऊ शकतं.
एखाद्या विद्यार्थ्याला वाचनात अडचण असेल, तर Indic-Speak मॉडेल त्याच्यासाठी तोच मजकूर मराठीत बोलून दाखवू शकतं. एखाद्या जुन्या हस्तलिखित नोंदवहीतली किंवा जुन्या पाठ्यपुस्तकातली माहिती डिजिटल करायची असेल, तर Indic-OCR ते काम करू शकतं. आणि एखाद्या विद्यार्थ्याला टायपिंग जमत नसेल, तर तो नुसतं मराठीत बोलून आपले प्रश्न विचारू शकतो, जे Indic-Transcribe त्याला अचूक टेक्स्टमध्ये बदलेल.
म्हणजे थोडक्यात, या चार मॉडेल्समुळे मराठी भाषेत शिकणाऱ्या, शिकवणाऱ्या आणि शिक्षणासाठी तंत्रज्ञान वापरणाऱ्या प्रत्येकासाठी एक नवीन, अधिक सुलभ मार्ग खुला होतो आहे.
हे भारतासाठी इतकं महत्त्वाचं का आहे
भारतात कोट्यवधी लोक दैनंदिन जीवनात इंग्रजीपेक्षा आपापल्या मातृभाषेत जास्त सहज आणि आत्मविश्वासाने व्यक्त होतात. पण आतापर्यंतचे बहुतेक शक्तिशाली AI मॉडेल्स अमेरिका किंवा युरोपमध्ये, प्रामुख्याने इंग्रजी डेटावर तयार झालेले आहेत. यामुळे एक मोठी दरी तयार झाली होती, ज्यांना इंग्रजी चांगलं येतं त्यांना AI चा पुरेपूर फायदा मिळत होता, पण उर्वरित मोठ्या लोकसंख्येला तेवढाच फायदा मिळत नव्हता.
Bodhan AI आणि AI4Bharat सारखे प्रकल्प नेमकी हीच दरी भरून काढण्याचा प्रयत्न करत आहेत. आणि हे केवळ शिक्षणापुरतं मर्यादित राहणार नाही, कारण एकदा या पद्धतीच्या टूल, खुल्या भारतीय भाषा मॉडेल्सचा पाया तयार झाला, की त्यावर आधारित शेती, आरोग्य, बँकिंग यांसारख्या इतर क्षेत्रांतही मराठीसह सर्व भारतीय भाषांसाठी नवीन AI उपाय वेगाने तयार होऊ शकतात. आपण
याआधीच्या लेखात बघितलेलं MahaVISTAAR-AI हे त्याचंच एक उदाहरण आहे, जिथे शेतीविषयक AI सल्ला मराठीत आणि आवाजाने दिला जातो.
पुढे काय अपेक्षित आहे
सध्या हे मॉडेल्स प्रामुख्याने developers, संशोधक, एडटेक कंपन्या आणि सरकारी संस्थांसाठी उपलब्ध करून देण्यात आले आहेत, म्हणजे सर्वसामान्य वाचकाला उद्याच एखादं थेट अॅप वापरायला मिळेल असं नाही. पण याच पायावर पुढच्या काही महिन्यांत विविध कंपन्या आणि संस्था नवीन, प्रत्यक्ष वापरता येण्याजोगी उत्पादनं तयार करतील अशी अपेक्षा आहे.
ज्यांना तंत्रज्ञानात रस आहे, किंवा जे स्वतः एखादा मराठी AI प्रकल्प उभारण्याचा विचार करत आहेत, त्यांच्यासाठी ही एक उत्तम संधी आहे, कारण आता या दर्जाची पायाभूत मॉडेल्स स्वतः तयार न करता, तयार, मोफत आणि खुल्या स्वरूपात उपलब्ध आहेत.
अधिक वाचा (Mee Marathi)
या विषयाशी संबंधित MahaVISTAAR-AI, Alibaba Qwen ecosystem आणि महाराष्ट्र AI पॉलिसी 2026 हे लेख वाचा.
अधिकृत स्रोत (Official Sources)
वारंवार विचारले जाणारे प्रश्न (FAQ)
Bodhan AI चे मॉडेल्स मराठीत काम करतात का? होय. Indic-Transcribe हे मॉडेल 27 भारतीय भाषा आणि बोलींना सामावून घेतं, ज्यात मराठीचाही समावेश आहे.
हे मॉडेल्स सामान्य वापरकर्त्याला आत्ताच वापरता येतील का? सध्या हे मुख्यतः developers, एडटेक कंपन्या आणि संशोधकांसाठी उपलब्ध आहेत. सर्वसामान्य वाचकांसाठी यावर आधारित अॅप्स आणि सेवा येत्या काही महिन्यांत यायला सुरुवात होईल.
हे मॉडेल्स वापरण्यासाठी पैसे लागतात का? हे मॉडेल्स open-weight स्वरूपात मोफत उपलब्ध आहेत, आणि यावर आधारित शैक्षणिक अॅप्लिकेशन्स विद्यार्थी व शिक्षकांसाठी मोफत राहतील असं Bodhan AI ने स्पष्ट केलं आहे.
AI4Bharat आणि Bodhan AI यात काय फरक आहे? AI4Bharat हे IIT Madras मधलं भारतीय भाषा संशोधन केंद्र आहे, तर Bodhan AI ही खास शिक्षण क्षेत्रातल्या AI साठी काम करणारी संस्था आहे. दोघे मिळून हे मॉडेल्स तयार करत आहेत.